AI 不只是会聊天,更要能像人一样
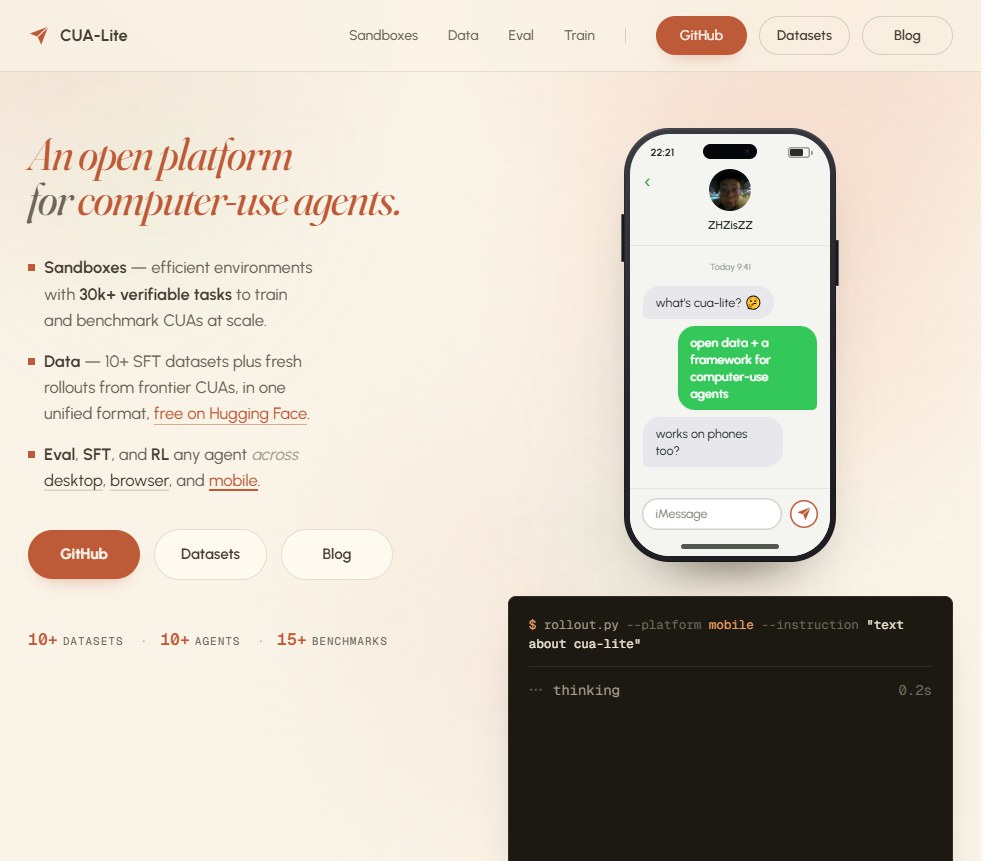
看懂屏幕、点击鼠标、操作软件—— 这就是 Computer-Use Agent(CUA),”会用电脑的智能体”。但过去做这件事,环境、数据集、评测、训练全是碎片化的,各搞一套、格式不统一、虚拟机开销巨大。现在,来自 UC Berkeley 的研究者推出了
CUA-Lite,用 “
一套动作空间、一份统一数据格式、一条命令跑全平台” 的设计,把桌面、浏览器、移动端的智能体开发全部打通。

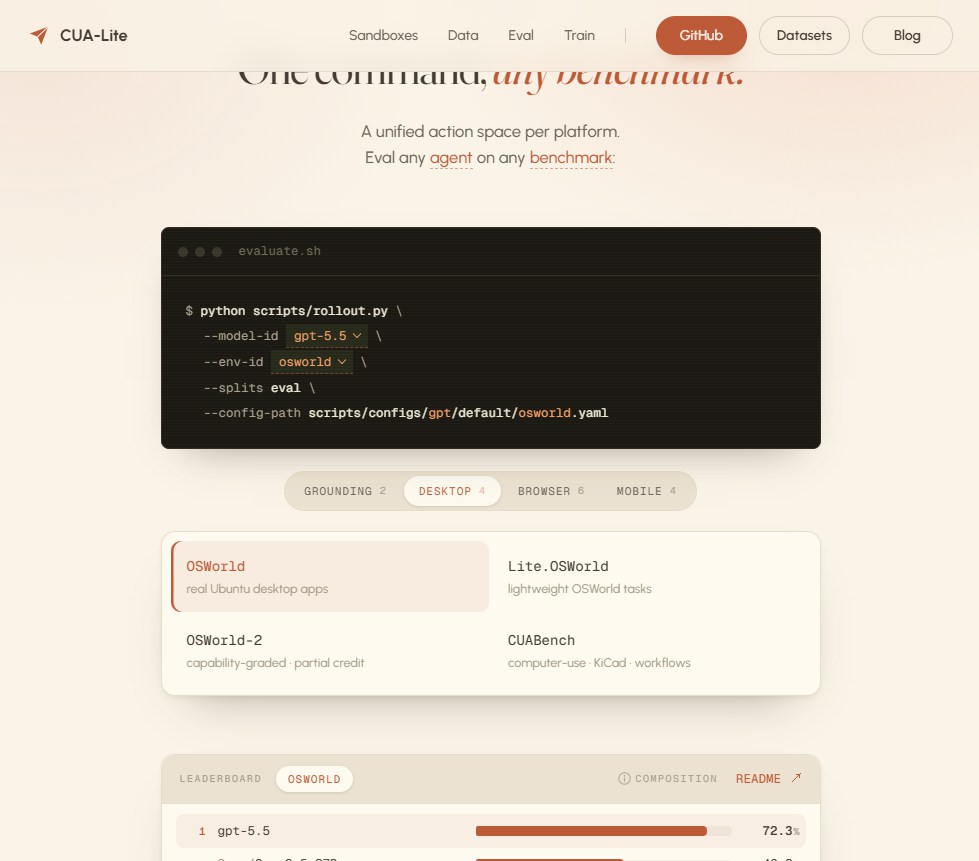
CUA-Lite 网站截图
🧩 三大核心:沙盒、数据、评测训练,一站式搞定
🖥️ 轻量沙盒:不用虚拟机,容器就能跑
传统评测环境依赖完整虚拟机,单台就要 4.1 GB 内存。CUA-Lite 推出 Lite.OSWorld,把桌面任务套件放进普通 Docker 容器,内存直降 0.9 GB,密度提升约 4.6 倍,云主机、CI 流水线都能直接并行部署,任务保真度与原虚拟机完全一致,训练信号不打折。平台累计提供 30,000+ 可验证任务,覆盖桌面、浏览器、Android 移动端三大场景,开箱即用。
📊 统一数据格式:一份 LiteSample,走遍所有模型
最大痛点是 “各家数据格式互不兼容”—— 换个模型就要重写转换脚本。CUA-Lite 定义 LiteSample 标准:截图 + 动作轨迹统一存储,10+ 主流公开数据集全部预处理成同一格式,免费在 Hugging Face 开放下载。从 GPT-5.5、Claude 到通义千问、UI-TARS、EvoCUA 等开源模型,一套格式通调所有,不用再反复适配。
📈 评测 + 训练:一条命令,通跑所有基准
- 15+ 权威基准:OSWorld、WebArena、AndroidWorld、VisualWebArena 等全覆盖
- 13+ 主流模型:闭源 / 开源模型统一接入、直接对比
- 支持 SFT 监督微调 + RL 强化学习:下载数据→导出模型格式→启动训练,三步到位
- 实时排行榜:公开模型得分与成功率,谁强谁弱一目了然
💡 一句话价值
CUA-Lite = 轻量化沙盒(容器替代 VM)+ 统一数据格式(LiteSample)+ 全平台评测与训练(桌面 / 浏览器 / 移动端)。它把过去 “各自造轮子、环境跑不起、数据对不齐、结果没法比” 的混乱局面,变成了标准、高效、可复现的智能体开发流水线 —— 无论是研究机构还是开发者团队,都能专注于模型创新而非基础设施适配。